TSFind — Lo que un directorio de proveedores me enseñó sobre APIs y datos
Sector: Web / APIs / Bases de datos / SEO
Periodo: abril - octubre de 2026 (en pausa)
Cliente: Proyecto propio — Trusted Services Finder (tsfind.com)
Contexto
Elegir a un profesional o a un proveedor de servicios suele ser elegir a ciegas: las reseñas en línea son fáciles de falsear. Con Trusted Services Finder quise construir un directorio de proveedores locales basado en tres pilares: fichas vinculadas al registro mercantil oficial, reseñas estructuradas que pueden acompañarse de una prueba (factura, foto) y una puntuación de confianza ponderada.
El principio comercial: aparecer es gratis, la empresa puede reclamar su ficha gratis y paga por herramientas y visibilidad, nunca por su reputación. El sitio se desarrolló de abril a agosto de 2026, en inglés, francés y español, con Suiza y México como primeros mercados.
Problema
- Llenar un directorio sin pagar miles de llamadas a APIs ni importar fichas vacías
- Demostrar que una persona es realmente dueña de la empresa que reclama
- Exponer datos públicos (fichas, reseñas) sin exponer datos privados (pruebas, contactos, suscripciones)
- Ser encontrado por Google en tres idiomas, con decenas de miles de páginas
Solución
Lo que se construyó:
- Un directorio por país, ciudad y categoría (57 categorías), con búsqueda y mapa de OpenStreetMap
- El alta de una empresa desde los registros oficiales gratuitos (Zefix en Suiza, DENUE en México) o desde Google Places
- La reclamación de una ficha mediante código por correo (solo si el dominio coincide con el sitio conocido por Google), por WhatsApp o con un documento verificado a mano
- Reseñas sobre 6 criterios, con prueba opcional y respuesta del propietario; una puntuación de confianza ponderada
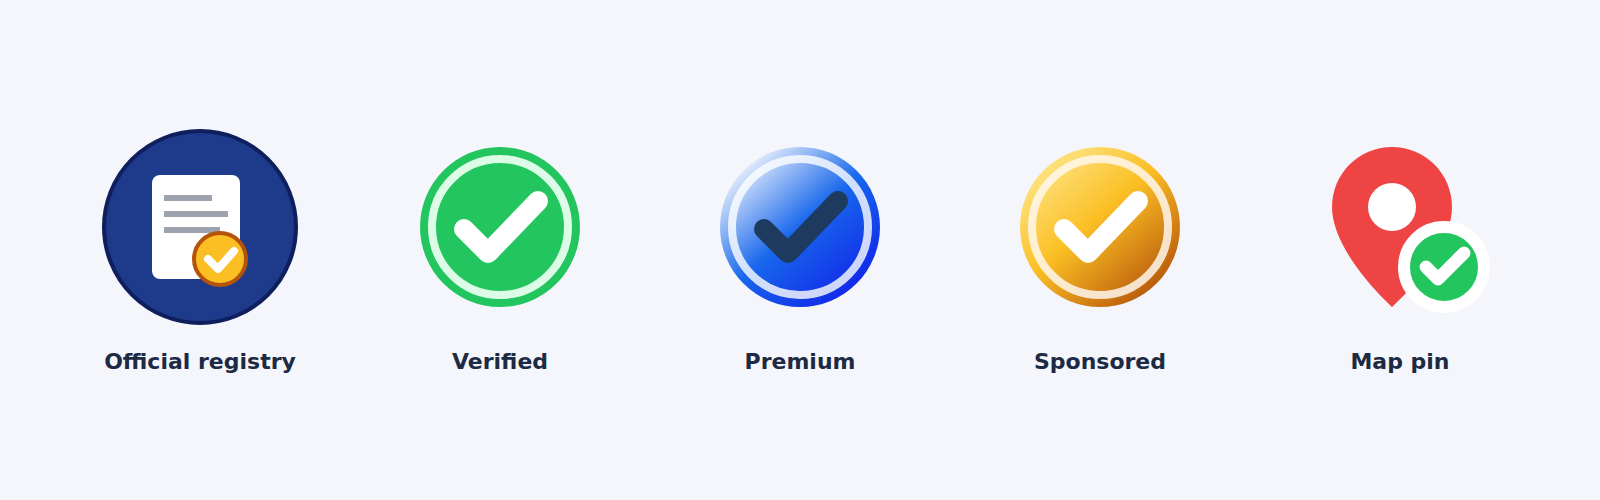
- Un panel del propietario, suscripciones con Stripe, una insignia para integrar en su sitio y un generador de códigos QR
- Un blog multilingüe gestionado en el CMS Directus y una administración completa (moderación, reclamaciones, exportación)
Lo que este proyecto me enseñó
1. Consumir APIs externas con fetch
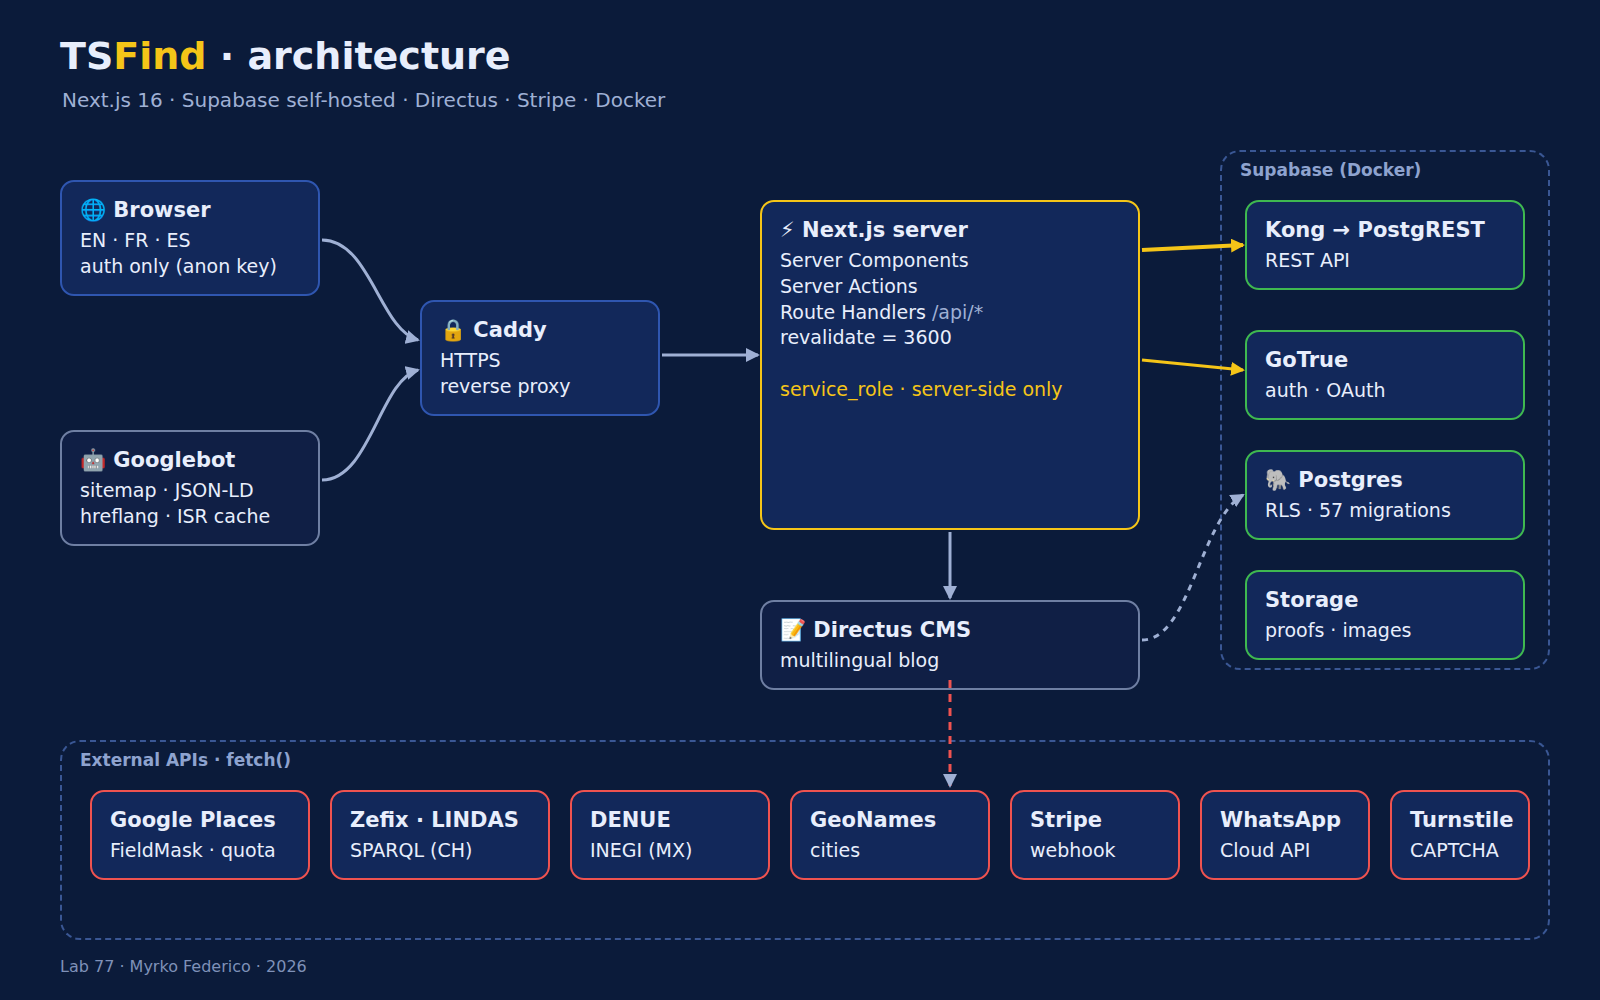
El sitio llama a seis servicios externos, todos con el fetch nativo del lado del servidor: Google Places, el registro suizo Zefix (en SPARQL), el registro mexicano DENUE, GeoNames, Cloudflare Turnstile y la API de WhatsApp de Meta. Cada uno me enseñó algo.
- El FieldMask es la factura. Con Google Places (New) se paga según los campos solicitados. Uso una máscara completa para la búsqueda y una mínima (teléfono y sitio web) para verificar una reclamación.
- Aprovechar cada llamada de pago. Una búsqueda devuelve 20 resultados: el usuario elige uno y los otros 19 se importan sin costo adicional.
- Una cuota se cuenta en la base de datos. Cada llamada de pago escribe una fila en una tabla de seguimiento. Antes de llamar se comprueban una cuota por usuario y una cuota mensual global, por debajo del nivel gratuito de Google. Y el seguimiento nunca debe bloquear la llamada de negocio.
- Una caché propia con tiempo de vida. Los detalles de una empresa se guardan 24 horas en la base de datos: cada relectura es gratuita.
- Conocer el rendimiento de una API pública. El registro suizo responde en 7 a 30 segundos según la consulta: el filtrado pesado se hace en el código, y toda entrada del usuario se escapa antes de entrar en una consulta SPARQL.
- Fallar con elegancia. Cada conector devuelve una lista vacía en lugar de romper la página cuando la API responde mal.
- La fuente de verdad no siempre es tu propia base de datos. Para validar una reclamación, el servidor vuelve a leer Google en directo: una ficha modificada justo antes no puede engañar la verificación.
const res = await fetch(`${PLACES_API}:searchText`, {
  method: "POST",
  headers: {
    "Content-Type": "application/json",
    "X-Goog-Api-Key": process.env.GOOGLE_PLACES_API_KEY!, // server-side only
    "X-Goog-FieldMask": "places.id,places.displayName,places.formattedAddress",
  },
  body: JSON.stringify({ textQuery: query, maxResultCount: 20 }),
});
if (!res.ok) return [];          // fail gracefully, never crash the page
2. Exponer tus propios servicios web
- El webhook de Stripe: leer el cuerpo en bruto de la petición, verificar la firma y rechazar todo lo demás. El identificador de la ficha viaja en los metadatos de Stripe, lo que vincula un pago a una empresa.
- Una API pública mínima para la insignia: solo datos ya visibles en la ficha, solo para fichas verificadas, de solo lectura con CORS.
- Contar las visitas correctamente. El conteo del lado del servidor contaba también los robots y los prerrenderizados. La solución: una pequeña señal enviada por el navegador, sin duplicados por sesión. Como los robots no ejecutan JavaScript, ya no cuentan.
export async function POST(request: Request) {
  const rawBody = Buffer.from(await request.arrayBuffer());
  const signature = request.headers.get("stripe-signature") ?? "";
  let event: Stripe.Event;
  try {
    event = stripe.webhooks.constructEvent(rawBody, signature, process.env.STRIPE_WEBHOOK_SECRET!);
  } catch {
    return new Response("Invalid signature", { status: 400 });
  }
  // event.data.object.metadata.profile_id -> update the listing tier
}
3. Una base de datos «pública», filtrada de forma selectiva
Supabase expone PostgreSQL directamente como API REST. La clave «anon» es pública por naturaleza: termina en el JavaScript del navegador. Es la Row Level Security (RLS) de PostgreSQL la que decide, fila por fila, lo que cada rol puede leer o escribir.
-- An anonymous visitor only sees published reviews
CREATE POLICY "Public read published reviews" ON reviews
  FOR SELECT TO anon
  USING (moderation_status = 'published');

-- A signed-in user also sees their own reviews awaiting moderation
CREATE POLICY "Authenticated read reviews" ON reviews
  FOR SELECT TO authenticated
  USING (moderation_status = 'published' OR reviewer_user_id = auth.uid());
Empecé así y luego cambié de opinión. Cuanto más se enriquecía el modelo de datos (reclamaciones, pruebas, datos personales, suscripciones), más difícil era mantener las políticas correctas: hicieron falta varias migraciones para corregir uno a uno los avisos de seguridad de Supabase. Así que trasladé todo el acceso a los datos al servidor:
- En el navegador, la clave pública ya solo sirve para la autenticación (inicio de sesión, registro).
- Todas las lecturas y escrituras pasan por el servidor Next.js, que elige exactamente las columnas, comprueba la propiedad y oculta los datos sensibles al mostrarlos.
- Se revocan los privilegios SQL de los roles públicos y la RLS sigue activa como defensa en profundidad. La clave de administración nunca sale del servidor.
REVOKE ALL ON ALL TABLES IN SCHEMA public FROM anon;
REVOKE ALL ON ALL TABLES IN SCHEMA public FROM authenticated;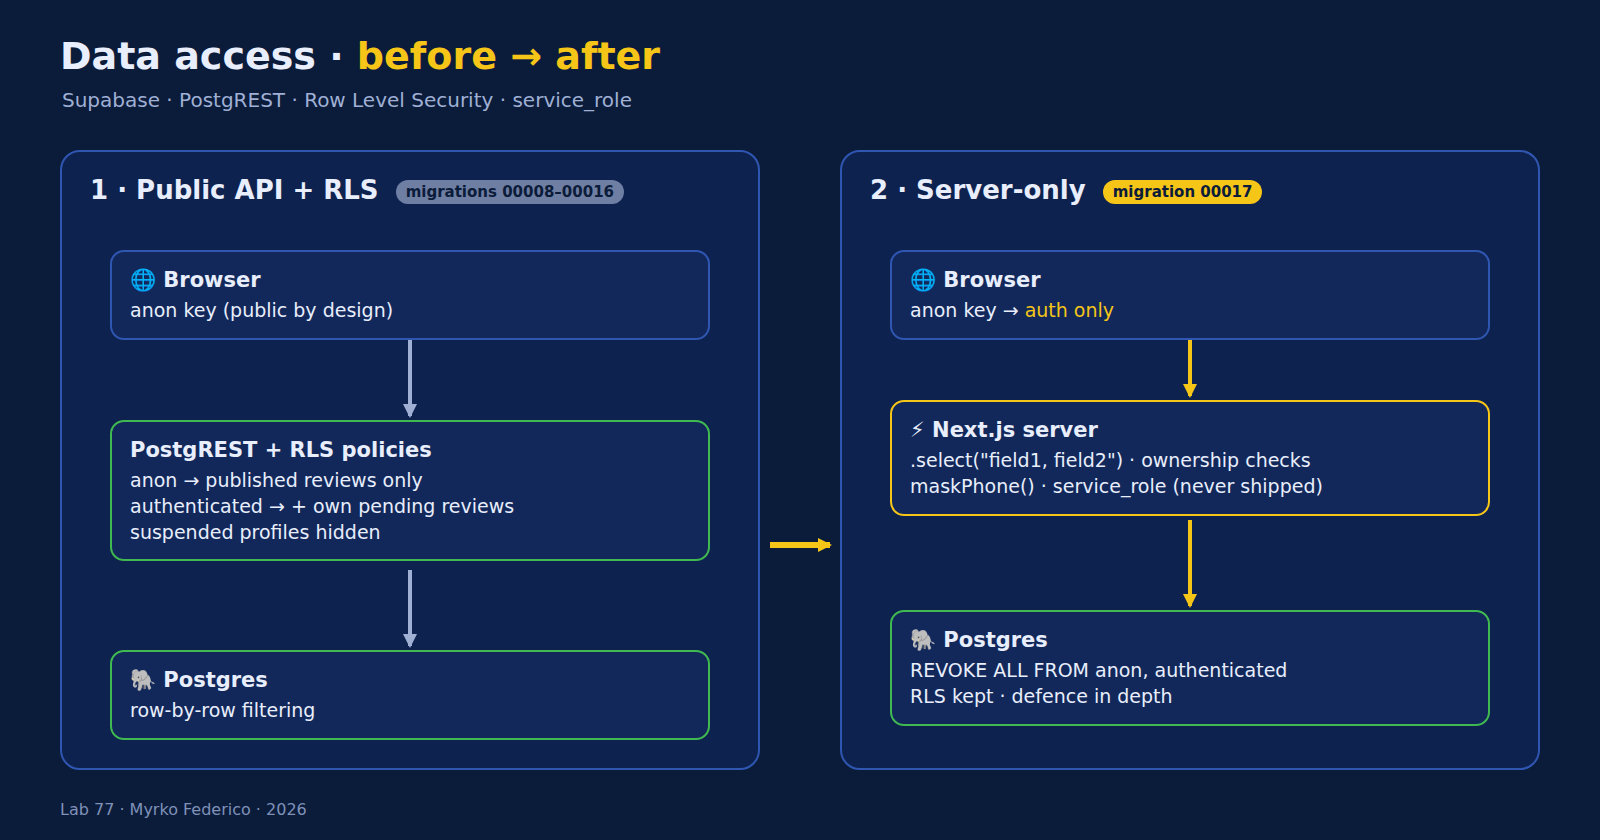
La lección: la RLS es imprescindible si el navegador consulta la base de datos directamente. Pero en cuanto los datos se vuelven sensibles, pasar el acceso por un servidor es más fácil de razonar y más seguro. Otras trampas: el límite de 1000 filas por respuesta de PostgREST (la administración solo mostraba un tercio de las fichas) y las funciones que se ejecutan con los privilegios de su creador, de las que hay que saber exactamente quién puede llamarlas.
4. SEO multilingüe
- Cada página declara su URL canónica y sus versiones de idioma (hreflang en, fr, es y x-default), con Open Graph.
- Datos estructurados Schema.org: empresa local, dirección, valoración media, reseñas, migas de pan, FAQ.
- El sitemap tuvo tres versiones: un solo archivo, luego una división que Google no lograba leer y después de nuevo un archivo único, paginado y limitado por debajo del tope de 50 000 URL, con una fecha de modificación estable. Una fecha que cambia en cada lectura baja la prioridad de indexación.
- Una trampa discreta: el middleware de autenticación marcaba todas las páginas como «privadas, sin caché». Hubo que forzar una caché pública en las páginas públicas.
5. Desplegar y mantenerse dentro de la memoria
- Las variables públicas de Next.js quedan fijadas en la compilación: añadir una obliga a reconstruir la imagen Docker.
- Todo lo que no está en el repositorio acabará sobrescrito. Los límites de memoria solo existían en el servidor; un despliegue los borró y la aplicación saturó una máquina compartida. Desde entonces el límite está versionado, con el heap de Node fijado en torno al 75 % del tope, para obtener un error legible en lugar de una parada silenciosa.
- Un único script de despliegue, nunca a mano, y nunca arquitectura y código en el mismo despliegue.
- El retorno de la inversión antes que la técnica. Se descartó la verificación automática de documentos por OCR: horas de desarrollo y un riesgo de seguridad para ahorrar menos de una hora de trabajo manual al mes.
mem_limit: 1g
memswap_limit: 1g                          # same as mem_limit: no swap
environment:
  - NODE_OPTIONS=--max-old-space-size=768  # ~75% of the cap
Resultado
Entregable:
- Más de 35 000 empresas indexadas en 50 países y 28 000 ciudades, 57 categorías, dos registros oficiales integrados
- Un sitio completo en tres idiomas: reclamaciones, reseñas, suscripciones, blog, administración
- Unas 290 confirmaciones y 57 migraciones SQL en cuatro meses de desarrollo
Y un balance honesto: la oferta estaba, la demanda no llegó. A finales de agosto, tras 35 000 fichas, solo había 5 fichas reclamadas y 3 reseñas, sin ninguna suscripción de pago; al ponerlo en pausa, el sitio recibía unos 35 visitantes al mes. Un directorio necesita a la vez visitantes, empresas activas y confianza: la diferenciación (registro oficial, pruebas) era real, pero no resuelve la distribución. El sitio está en pausa desde octubre de 2026; los datos se conservan.
Este proyecto demuestra:
- El dominio de las APIs externas: costos, cuotas, caché, errores, fuentes de verdad
- El diseño de servicios web seguros: webhooks firmados, API pública mínima, conteo fiable
- La seguridad de los datos: RLS, revocación de privilegios, acceso reservado al servidor
- El SEO técnico multilingüe a gran escala, y la lucidez de pausar un proyecto cuando el mercado no responde
¿Necesita infraestructura o agentes de IA para su empresa?
Servidores autoalojados, ERP Odoo, agentes de IA, automatización: analizo su stack y le propongo una solución soberana y mantenible.
Etiquetas: lab, Next.js, Supabase, PostgreSQL, Row Level Security, API, fetch, webhooks, Stripe, SEO, Docker