TSFind — Ce qu'un annuaire de prestataires m'a appris sur les API et les données
Secteur : Web / API / Bases de données / SEO
Période : avril - octobre 2026 (en pause)
Client : Projet propre — Trusted Services Finder (tsfind.com)
Contexte
Choisir un artisan ou un prestataire, c'est souvent choisir à l'aveugle : les avis en ligne sont faciles à truquer. Avec Trusted Services Finder, j'ai voulu construire un annuaire de prestataires locaux qui repose sur trois piliers : des fiches rattachées au registre du commerce officiel, des avis structurés qui peuvent être accompagnés d'une preuve (facture, photo), et un score de confiance pondéré.
Le principe commercial : la présence est gratuite, l'entreprise peut revendiquer sa fiche gratuitement, et elle paie pour des outils et de la visibilité, jamais pour sa réputation. Le site a été développé d'avril à août 2026, en anglais, français et espagnol, avec la Suisse et le Mexique comme premiers marchés.
Problème
- Remplir un annuaire sans payer des milliers d'appels d'API, ni importer des fiches vides
- Prouver qu'une personne est bien propriétaire de l'entreprise qu'elle revendique
- Exposer des données publiques (fiches, avis) sans exposer les données privées (preuves, contacts, abonnements)
- Être trouvé par Google dans trois langues, avec des dizaines de milliers de pages
Solution
Ce qui a été construit :
- Un annuaire par pays, ville et catégorie (57 catégories), avec recherche et carte OpenStreetMap
- L'ajout d'une entreprise depuis les registres officiels gratuits (Zefix en Suisse, DENUE au Mexique) ou depuis Google Places
- La revendication d'une fiche par code e-mail (seulement si le domaine correspond au site connu de Google), par WhatsApp ou par document vérifié à la main
- Des avis sur 6 critères, avec preuve facultative et réponse du propriétaire ; un score de confiance pondéré
- Un tableau de bord propriétaire, des abonnements Stripe, un badge à intégrer sur son site et un générateur de QR code
- Un blog multilingue géré dans le CMS Directus, et une administration complète (modération, revendications, export)
Ce que ce projet m'a appris
1. Consommer des API externes avec fetch
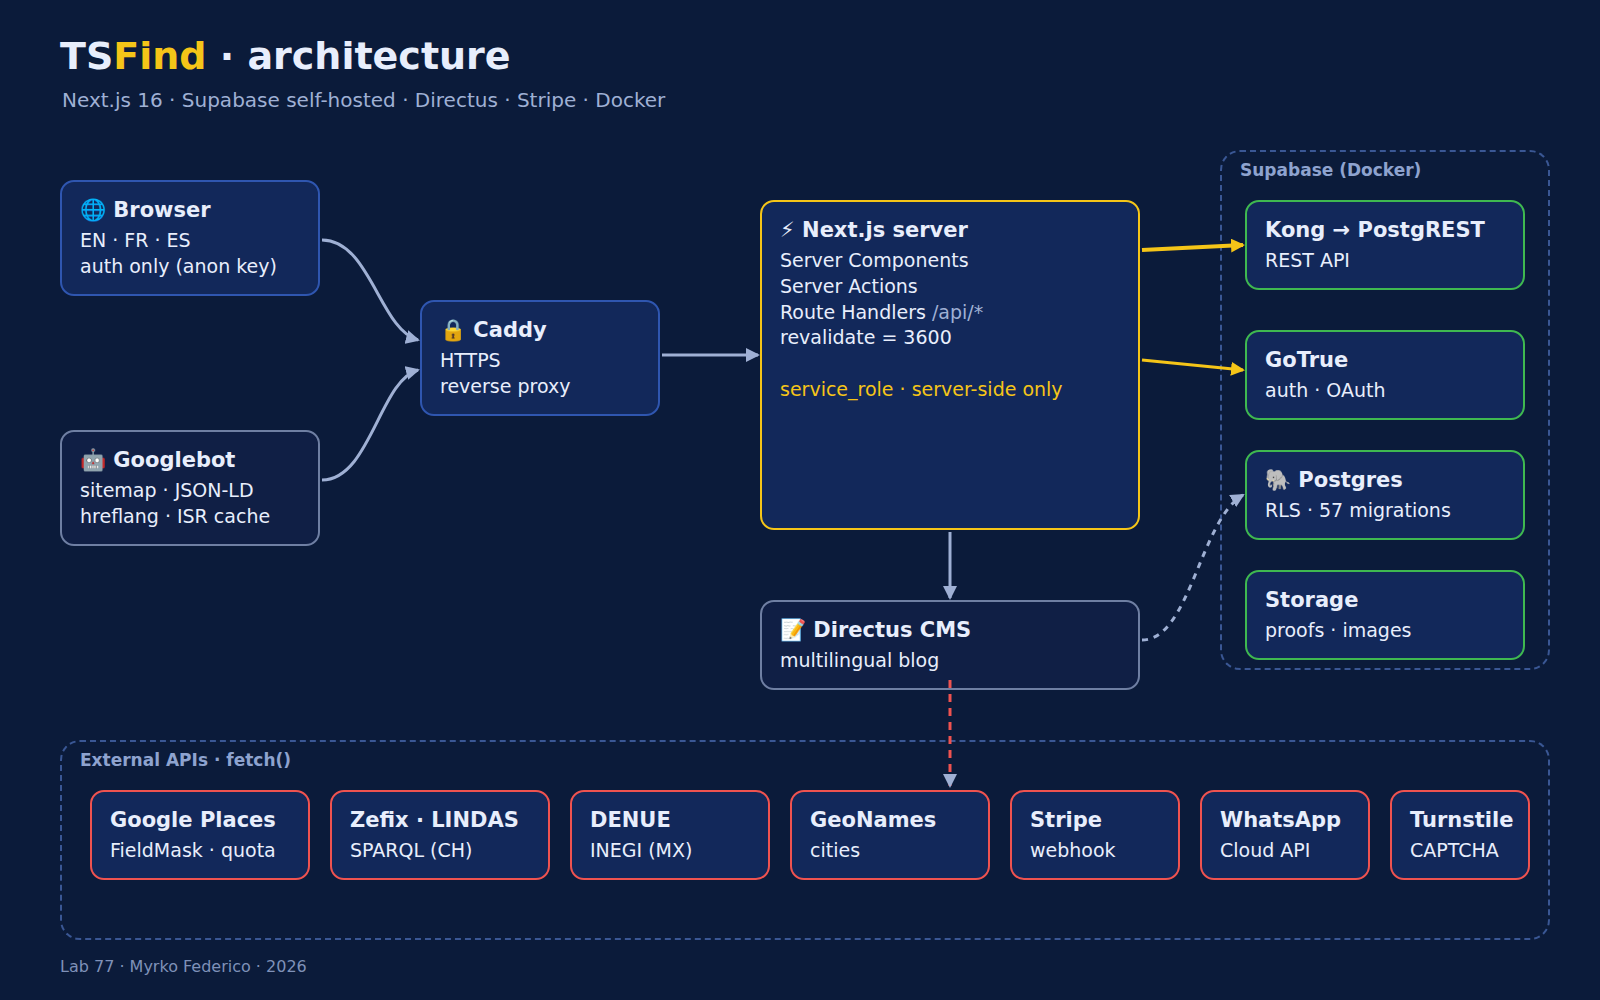
Le site appelle six services externes, tous avec le fetch natif côté serveur : Google Places, le registre suisse Zefix (en SPARQL), le registre mexicain DENUE, GeoNames, Cloudflare Turnstile et l'API WhatsApp de Meta. Chacun m'a appris quelque chose.
- Le FieldMask, c'est la facture. Avec Google Places (New), on paie selon les champs demandés. J'utilise un masque complet pour la recherche et un masque minimal (téléphone et site web) pour vérifier une revendication.
- Rentabiliser chaque appel payant. Une recherche renvoie 20 résultats : l'utilisateur en choisit un, les 19 autres sont importés sans coût supplémentaire.
- Un quota se compte en base. Chaque appel payant écrit une ligne dans une table de suivi. Avant d'appeler, on vérifie un quota par utilisateur et un quota mensuel global, calé sous le palier gratuit de Google. Et le suivi ne doit jamais bloquer l'appel métier.
- Un cache maison avec durée de vie. Les détails d'une entreprise sont gardés 24 heures en base : chaque relecture est gratuite.
- Connaître les performances d'une API publique. Le registre suisse répond en 7 à 30 secondes selon la requête : le filtrage lourd se fait donc dans le code, et toute saisie utilisateur est échappée avant d'entrer dans une requête SPARQL.
- Échouer proprement. Chaque connecteur renvoie une liste vide plutôt que de faire planter la page quand l'API répond mal.
- La source de vérité n'est pas toujours sa propre base. Pour valider une revendication, le serveur relit Google en direct : une fiche modifiée juste avant ne peut pas tromper la vérification.
const res = await fetch(`${PLACES_API}:searchText`, {
  method: "POST",
  headers: {
    "Content-Type": "application/json",
    "X-Goog-Api-Key": process.env.GOOGLE_PLACES_API_KEY!, // server-side only
    "X-Goog-FieldMask": "places.id,places.displayName,places.formattedAddress",
  },
  body: JSON.stringify({ textQuery: query, maxResultCount: 20 }),
});
if (!res.ok) return [];          // fail gracefully, never crash the page
2. Exposer ses propres webservices
- Le webhook Stripe : lire le corps brut de la requête, vérifier la signature, refuser tout le reste. L'identifiant de la fiche voyage dans les métadonnées de Stripe, ce qui relie un paiement à une entreprise.
- Une API publique minimale pour le badge : uniquement des données déjà visibles sur la fiche, uniquement pour les fiches vérifiées, en lecture seule avec CORS.
- Compter les vues correctement. Le comptage côté serveur comptait aussi les robots et les pré-rendus. La solution : un petit signal envoyé par le navigateur, dédoublonné par session. Les robots n'exécutant pas le JavaScript, ils ne comptent plus.
export async function POST(request: Request) {
  const rawBody = Buffer.from(await request.arrayBuffer());
  const signature = request.headers.get("stripe-signature") ?? "";
  let event: Stripe.Event;
  try {
    event = stripe.webhooks.constructEvent(rawBody, signature, process.env.STRIPE_WEBHOOK_SECRET!);
  } catch {
    return new Response("Invalid signature", { status: 400 });
  }
  // event.data.object.metadata.profile_id -> update the listing tier
}
3. Une base de données « publique », filtrée de façon sélective
Supabase expose PostgreSQL directement sous forme d'API REST. La clé « anon » est publique par nature : elle se retrouve dans le JavaScript du navigateur. C'est la Row Level Security (RLS) de PostgreSQL qui décide, ligne par ligne, ce que chaque rôle peut lire ou écrire.
-- An anonymous visitor only sees published reviews
CREATE POLICY "Public read published reviews" ON reviews
  FOR SELECT TO anon
  USING (moderation_status = 'published');

-- A signed-in user also sees their own reviews awaiting moderation
CREATE POLICY "Authenticated read reviews" ON reviews
  FOR SELECT TO authenticated
  USING (moderation_status = 'published' OR reviewer_user_id = auth.uid());
J'ai commencé ainsi, puis j'ai changé d'avis. Plus le modèle de données s'enrichissait (revendications, preuves, données personnelles, abonnements), plus les policies devenaient difficiles à garder justes : plusieurs migrations ont été nécessaires pour corriger les avertissements de sécurité de Supabase, un par un. J'ai donc basculé tous les accès aux données vers le serveur :
- Dans le navigateur, la clé publique ne sert plus qu'à l'authentification (connexion, inscription).
- Toutes les lectures et écritures passent par le serveur Next.js, qui choisit précisément les colonnes, vérifie la propriété et masque les données sensibles à l'affichage.
- Les droits SQL des rôles publics sont révoqués, et la RLS reste active comme défense en profondeur. La clé d'administration ne quitte jamais le serveur.
REVOKE ALL ON ALL TABLES IN SCHEMA public FROM anon;
REVOKE ALL ON ALL TABLES IN SCHEMA public FROM authenticated;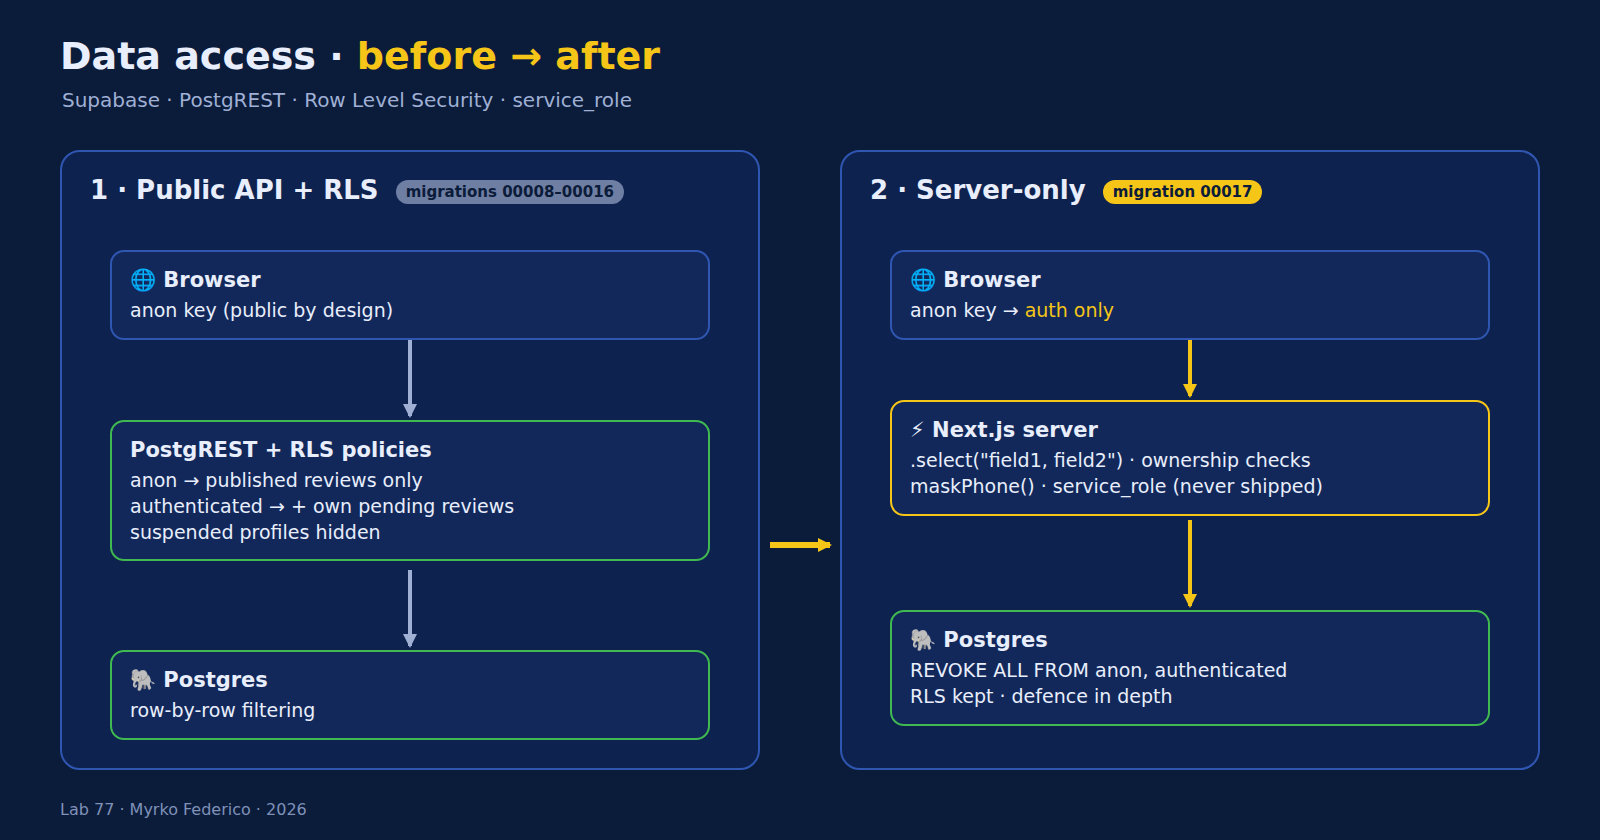
La leçon : la RLS est indispensable si le navigateur interroge la base directement. Mais dès que les données deviennent sensibles, faire passer les accès par un serveur est plus simple à raisonner et plus sûr. Autres pièges rencontrés : la limite de 1000 lignes par réponse de PostgREST (l'administration n'affichait qu'un tiers des fiches), et les fonctions qui s'exécutent avec les droits de leur créateur, dont il faut savoir exactement qui peut les appeler.
4. Le SEO multilingue
- Chaque page déclare son URL canonique et ses versions linguistiques (hreflang en, fr, es et x-default), avec Open Graph.
- Des données structurées Schema.org : entreprise locale, adresse, note moyenne, avis, fil d'Ariane, FAQ.
- Le sitemap a connu trois versions : un seul fichier, puis un découpage que Google n'arrivait pas à lire, puis retour à un fichier unique, paginé et plafonné sous la limite de 50 000 URL, avec une date de modification stable. Une date qui change à chaque lecture fait baisser la priorité d'indexation.
- Un piège discret : le middleware d'authentification marquait toutes les pages « privées, non mises en cache ». Il a fallu forcer un cache public sur les pages publiques.
5. Déployer et tenir dans la mémoire
- Les variables publiques de Next.js sont figées au build : en ajouter une demande de reconstruire l'image Docker.
- Tout ce qui n'est pas dans le dépôt finira écrasé. Des limites de mémoire existaient seulement sur le serveur ; un déploiement les a effacées, et l'application a saturé une machine partagée. Depuis, la limite est versionnée, avec un tas Node réglé à environ 75 % du plafond, pour obtenir une erreur lisible plutôt qu'un arrêt silencieux.
- Un seul script de déploiement, jamais de manipulation à la main, et jamais l'architecture et le code dans le même déploiement.
- Le retour sur investissement avant la technique. Une vérification automatique des documents par OCR a été écartée : des heures de développement et un risque de sécurité, pour moins d'une heure de travail manuel économisée par mois.
mem_limit: 1g
memswap_limit: 1g                          # same as mem_limit: no swap
environment:
  - NODE_OPTIONS=--max-old-space-size=768  # ~75% of the cap
Résultat
Livrable :
- Plus de 35 000 entreprises indexées dans 50 pays et 28 000 villes, 57 catégories, deux registres officiels intégrés
- Un site complet en trois langues : revendication, avis, abonnements, blog, administration
- Environ 290 commits et 57 migrations SQL en quatre mois de développement
Et l'honnêteté du bilan : l'offre était là, la demande n'a pas suivi. Fin août, après 35 000 fiches, il n'y avait que 5 fiches revendiquées et 3 avis, sans abonnement payant ; à la mise en pause, le site recevait environ 35 visiteurs par mois. Un annuaire a besoin à la fois de visiteurs, d'entreprises actives et de confiance : la différenciation (registre officiel, preuves) était réelle, mais elle ne résout pas la distribution. Le site est en pause depuis octobre 2026 ; les données sont conservées.
Ce projet démontre :
- La maîtrise des API externes : coûts, quotas, cache, erreurs, sources de vérité
- La conception de webservices sûrs : webhooks signés, API publique minimale, comptage fiable
- La sécurité des données : RLS, révocation des droits, accès réservé au serveur
- Le SEO technique multilingue à grande échelle, et la lucidité de mettre un projet en pause quand le marché ne répond pas
Besoin d'une infrastructure ou d'agents IA pour votre entreprise ?
Serveurs auto-hébergés, ERP Odoo, agents IA, automatisation : j'analyse votre stack et je vous propose une solution souveraine et maintenable.
Tags : lab, Next.js, Supabase, PostgreSQL, Row Level Security, API, fetch, webhooks, Stripe, SEO, Docker